Monitoreo remoto y analítica
Sector: Salud digital, monitoreo remoto de pacientes
El escenario
Imagina que estás construyendo un servicio de monitoreo remoto para pacientes con insuficiencia cardíaca crónica. Tu kit incluye una balanza Bluetooth, un oxímetro de pulso y un tensiómetro, cada uno de un proveedor distinto con su propio SDK, su nube y su formato de datos. El próximo trimestre llega un cuarto dispositivo, un monitor de glucosa.
Dos cosas te importan. La primera son las alertas: las señales más útiles son las que ocurren juntas, como un aumento de peso en dos días sumado a una frecuencia cardíaca en reposo creciente. La segunda es la analítica: tu equipo clínico, tus socios y tus inversores harán preguntas como "¿cómo les fue a los pacientes con este protocolo en seis meses?".
Qué sale mal sin la herramienta adecuada
- Cada proveedor obtiene su propio pipeline de ingesta, su propia tabla y sus propias reglas de alerta, así que cada dispositivo nuevo es un proyecto nuevo.
- Las reglas entre dispositivos se convierten en código a medida, porque las lecturas viven en lugares distintos, con marcas de tiempo y unidades diferentes.
- Cada pregunta de analítica se convierte en un pedido de ingeniería de datos.
- Cambiar el umbral de una alerta requiere un desarrollador, un despliegue y un riesgo de regresión.
- Nadie puede responder fácilmente "¿por qué este paciente recibió una alerta el día 12?", porque las lecturas y las reglas cambian con el tiempo.
Cómo se puede usar Atomik
- Modela los hechos clínicos, no los dispositivos. Define plantillas openEHR para lo que mides (peso corporal, presión arterial, saturación de oxígeno, glucemia) y súbelas a Atomik.
- Traduce al entrar. Una capa de integración convierte el mensaje de cada proveedor en una composición de la plantilla correspondiente y la guarda en el EHR del paciente por la API REST. Un dispositivo nuevo es un mapeo nuevo, no una base de datos nueva.
- Escribe la regla de alerta una sola vez. En el Constructor de consultas, crea una consulta para "aumento de peso en 48 horas" y otra para "frecuencia cardíaca en aumento", y combínalas (Consultas combinadas, una función premium) para que ambas se cumplan para el mismo paciente. Tu aplicación ejecuta la consulta por la API y dispara la alerta.
- Deja que el equipo clínico administre los umbrales. Las consultas se editan en la consola web, así que ajustar un umbral no requiere un despliegue.
- Reutiliza los mismos datos para analítica. Una cohorte ("pacientes con insuficiencia cardíaca y aumento de peso superior a X") es otra consulta guardada sobre el mismo registro, y los resultados pueden alimentar tus herramientas de BI o visualización por la API.
- Conserva la historia. Los datos están versionados y auditados, así que puedes reconstruir cómo era el registro de un paciente cuando se disparó una alerta.
Cómo puede ayudar CaboLabs
Mapear el mensaje de cada dispositivo a las plantillas, y diseñar la API alrededor, es trabajo de integración en el que puede ayudar CaboLabs, creador de Atomik: ver Diseño de APIs e Implementación openEHR. Atomik no requiere los servicios de CaboLabs.
Qué te da esto
Agregar un dispositivo pasa a ser un ejercicio de mapeo. Las alertas y la analítica salen de una sola definición de datos en lugar de varias. Quienes conocen las reglas clínicas pueden mantenerlas.
Por qué Atomik encaja
Los datos de dispositivos solo sirven cuando significan lo mismo sin importar quién fabricó el aparato. Atomik guarda los hechos clínicos en un estándar abierto, así que las alertas, los reportes y los dispositivos futuros trabajan sobre las mismas definiciones, y nada se sobrescribe.
Para profundizar
¿Estás construyendo un monitor de actividad física, un rastreador de sueño, una app de control de peso o una plataforma de monitoreo remoto de pacientes? Atomik actúa como el backend agregador canónico de datos — simplificando la ingesta, estandarizando el almacenamiento e impulsando alertas y recomendaciones automatizadas mediante consultas inteligentes.
Arquitectura y flujos de datos
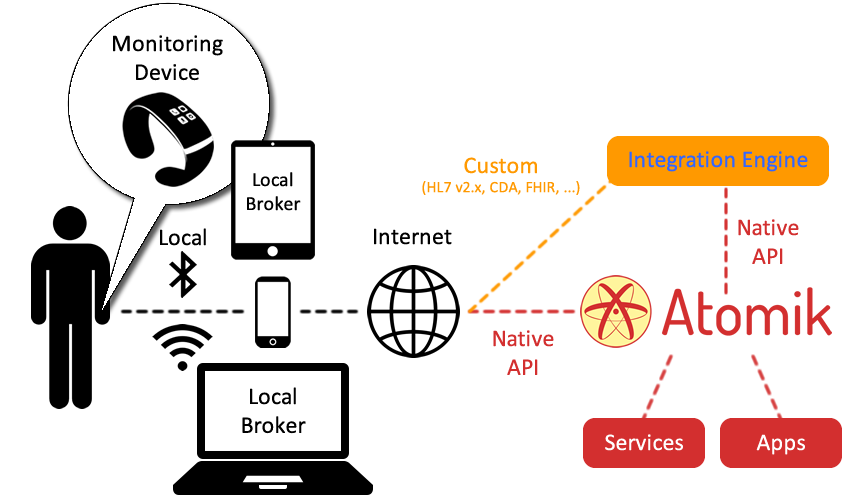
La arquitectura más común para dispositivos de monitoreo incluye un monitor físico que genera datos crudos a partir de signos vitales, análisis de sustancias químicas, estado del sueño, ejercicio y otros tipos de mediciones. El dispositivo de monitoreo comunica luego los datos crudos a un dispositivo cercano, comúnmente llamado "gateway". En general esa comunicación ocurre a través de BLE (Bluetooth Low Energy) o un protocolo PAN (Personal Area Network) similar.
El gateway tiene conexión a Internet y puede comunicar los datos crudos, tal vez preprocesados, a un servicio en la nube. Eso puede ser una comunicación directa (API Nativa) o vía un broker/motor de integración. Un broker transformaría los datos que llegan del gateway a un formato que el servicio en la nube pueda entender.
En este contexto, Atomik actúa como el servicio en la nube, donde los datos se almacenan en un formato estandarizado, y el objetivo del broker es transformar los datos crudos o parcialmente procesados en datos openEHR, ya que la API Nativa es conforme con openEHR.
La última pieza del rompecabezas es el análisis y la visualización de datos. Para dar soporte a esto, Atomik proporciona un Constructor de Consultas visual que permite a los usuarios crear consultas complejas sin habilidades de programación, las cuales pueden ejecutarse vía llamadas a la API. Esto permite crear cualquier cantidad de "servicios de datos", para acceder a datos de forma estandarizada, y alimentar cualquier solución de analítica o visualización.
El objetivo de Atomik es situarse en el medio entre la recolección/procesamiento de datos, y cómo se usarán finalmente esos datos para analítica/visualización, simplificando la gestión y el acceso a los datos de forma estandarizada y neutral respecto al proveedor.